
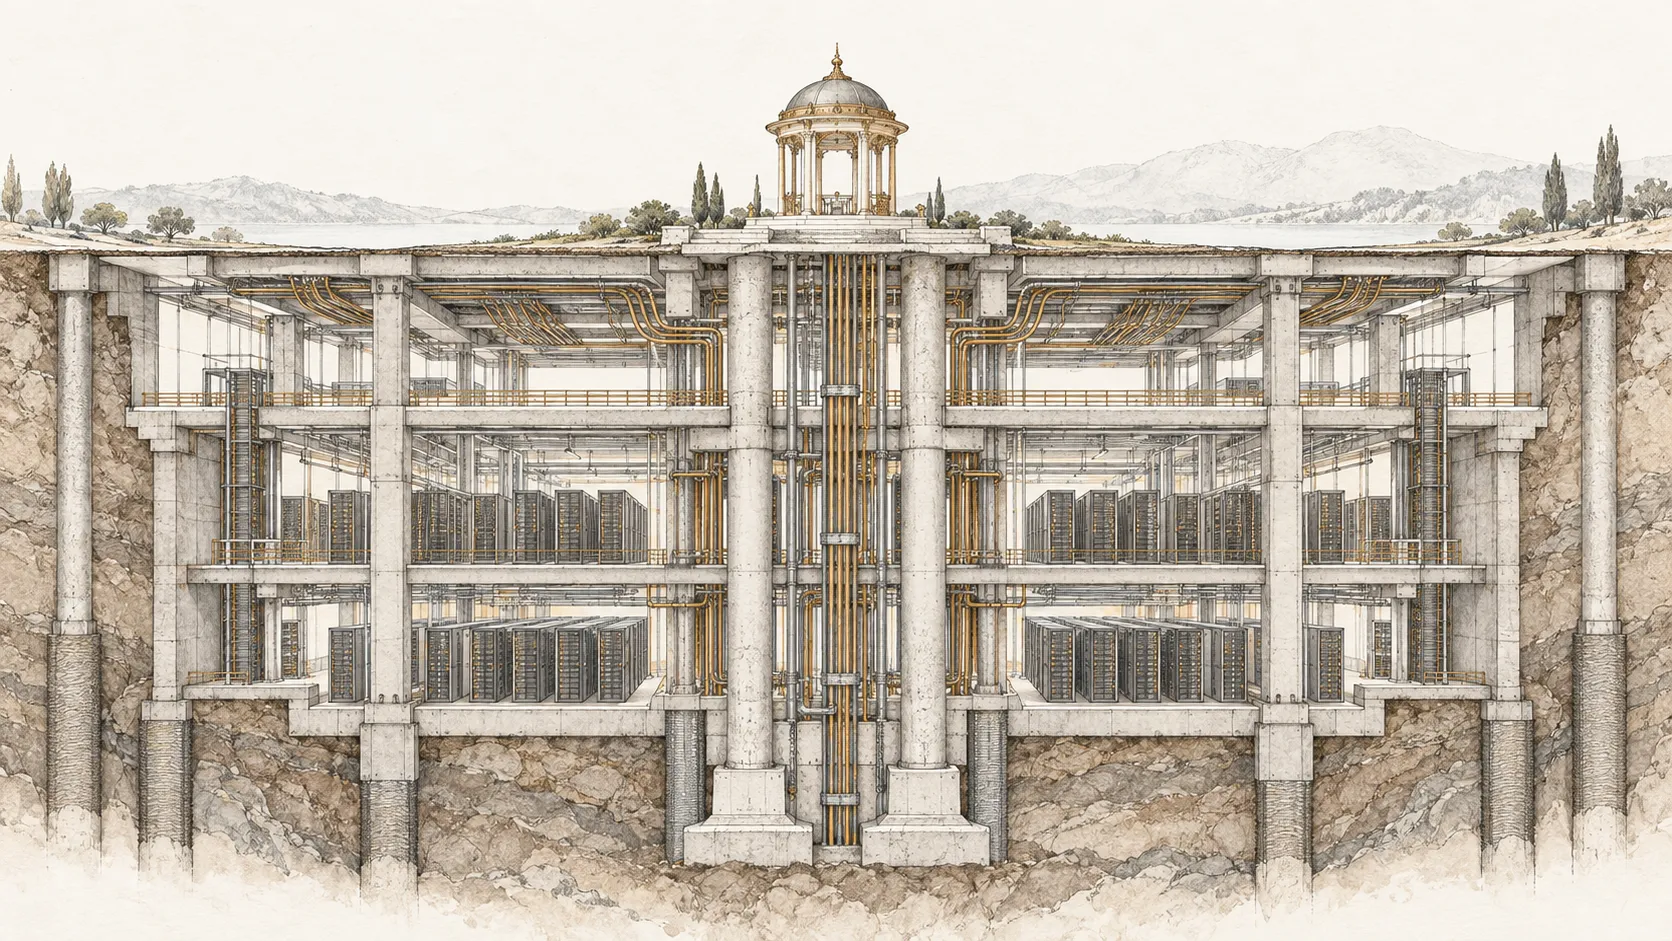
智能的上限,取决于系统的下限
这两年谈大模型,大家习惯先看排行榜。谁家的新模型又登顶了,比上一代高了几分,几乎每个月都有新闻。
我在微软做 AI 平台的那几年,真正让人睡不着觉的,却很少是模型本身。更多时候是凌晨的告警:某个节点掉了,训练任务挂了,上一次 Checkpoint 是什么时候存的,这一下要损失多少卡时。模型决定了能做到什么,系统决定了最后实际做到多少。我越来越相信,后者正在变成更关键的那一个。
排行榜正在变平
先看一组数字。斯坦福 2026 年的 AI Index 报告显示,截至 2026 年 3 月,Arena 排行榜上 Anthropic、xAI、Google、OpenAI 四家的最强模型,Elo 分数分别是 1503、1495、1494 和 1481,首尾只差 22 分。中美两国最强模型之间的差距,也只剩 2.7%。
22 个 Elo 分是什么概念?按 Elo 的定义,在两两盲测中,第一名胜过第四名的概率大约只有 53%,比抛硬币好不了多少。报告自己的判断也很直接:竞争的压力正在转向成本、可靠性和具体领域的表现。
模型当然重要,前沿的突破依然决定天花板在哪里。但对绝大多数要把 AI 真正用起来的团队来说,能拿到的模型差别已经不大了,差别在于能不能把它稳定、便宜、持续地跑起来。
训练:一万六千张卡,大约三小时坏一次
Meta 在 Llama 3 的技术报告里,难得公开了一份“故障账本”。405B 模型在最多 16384 张 H100 上预训练,在其中 54 天的观察窗口里,任务一共被打断了 466 次:47 次是计划内的维护,其余 419 次是意外。意外中断里,约 78% 被确认或怀疑是硬件问题,仅 GPU 相关就占了 58.7%。
折算下来,平均每三个小时左右,就有一次意外中断。
更要命的是,大模型的同步训练对故障几乎没有容忍度。一张卡出问题,整个任务往往都要停下来,从最近一次 Checkpoint 重新开始。在这样的故障频率下,Meta 依然做到了 90% 以上的有效训练时间,54 天里真正需要人工大规模介入的只有三次,其余都由自动化处理。论文里提到的办法并不神秘:缩短任务启动和 Checkpoint 的耗时,再加上一套能快速诊断问题的工具。
这恰恰是我在 Nebula 上花了很多时间的事情。Checkpoint 看上去只是“存个盘”,但在几千张卡的规模上,它是一个相当微妙的权衡。存得太勤,大量时间花在写盘上,GPU 只能干等;存得太疏,一旦出故障,上一个存档点之后的计算就全部白做了。
关于这个权衡,有一个很老的经验公式,出自 Young 在 1974 年的论文:最优的存档间隔,约等于“2 × 单次存档耗时 × 平均故障间隔”的平方根。可以粗略算一笔账。假设平均故障间隔是 3 小时,一次阻塞式存档要 10 分钟,那么最优间隔大约是 60 分钟,这时花在存档和故障返工上的时间,加起来接近总时长的三分之一。如果把单次存档耗时压缩到原来的五十分之一,也就是 12 秒左右,最优间隔会缩短到 8 分半钟,总损耗降到 5% 以下。
这只是一阶近似,还没算上重启和重新加载的时间,但量级没有错。我们在 Nebula 里做的三层 Checkpoint 存储,核心思路就是让训练进程尽快“甩掉”存档这件事:先写到离 GPU 最近、最快的那一层,训练立刻继续,再由后台逐级异步地落到持久化存储上。最终,Checkpoint 的保存效率提升了约 50 倍。
对研究员来说,这件事几乎是隐形的。但它直接决定了同样一笔算力预算里,有多少真正变成了模型的能力。
推理:便宜的 token,昂贵的系统
推理这边,故事的走向相反,道理却是一样的。
单个 token 正在变得极其便宜。斯坦福 2025 年的 AI Index 统计,达到 GPT-3.5 水平(MMLU 64.8 分)的模型,调用价格从 2022 年 11 月的每百万 token 20 美元,降到了 2024 年 10 月的 0.07 美元,18 个月里降了 280 多倍。
可我接触过的团队,AI 账单几乎都在上涨。原因并不复杂:单价降了,用量涨得更快;而 Agent 类应用完成一件事,要来回调用很多轮模型,消耗的 token 远远超过一次普通对话。单价是模型厂商的事,总账是系统的事。
在 MaaS 做 Runtime 和限流的那段时间,我体会最深的一点是:推理流量是不讲道理的。它有明显的潮汐,有突发,还有个别客户在一瞬间打满配额。面向 OpenAI、Azure OpenAI 这类后端引擎,我们设计 Rate Limit Service,说白了是在做三件事:保护后端不被打垮,在多个租户之间公平地分配有限的容量,在实在扛不住的时候有序降级,而不是大家一起崩溃。这几件事没有一件跟模型有多聪明有关,但每一件都决定了用户感受到的“智能”到底能不能用。
后来做 MoiAI,遇到的是同样的问题,只是换了个形态。在高并发、高 TPM 的场景里,请求路由到哪个模型,哪些可以合并,哪些上下文可以缓存,哪些步骤可以交给更小的模型去做,这些调度上的选择,常常比换一个“更强”的模型影响更大。
系统会不会学习
训练和推理之外,还有一个常被忽视的部分:数据闭环。
模型在上线的那一刻就停止了学习,但一个好的 AI 系统不会。用户在哪一步放弃了,哪类任务总要重试,哪些回答被手动改写,这些信号如果被系统地采集和分析,就会成为下一轮迭代最有价值的输入。我在微软 AI 平台负责过整个大团队的 Telemetry,做 MoiAI 时也是从第一天起就把它当作架构的一部分。没有这一层,团队对产品的判断,很大程度上是在猜。
两个用着同一个基础模型的产品,半年以后体验可以天差地别,差距往往就出在这里。
写在最后
如果说模型能力是天花板,系统就是地板。天花板决定了理论上能走多高,地板决定了你每天实际站在哪里。
过去几年,行业的注意力主要在抬高天花板,这完全可以理解。可当各家的天花板越来越接近,差异就会落到地板上:训练能不能稳定地跑完,推理能不能在高峰时扛住,成本能不能守住,系统能不能从使用中学习。
这些工作不性感,也很少出现在发布会上。但我越来越确定,接下来几年真正的护城河,会建在这里。
参考资料
- Stanford HAI, AI Index Report 2026, Technical Performance
- Stanford HAI, AI Index Report 2025
- Meta, The Llama 3 Herd of Models, 2024
- J. W. Young, “A First Order Approximation to the Optimum Checkpoint Interval”, Communications of the ACM, 1974